
Alla scoperta delle norme dedicate all’intelligenza artificiale
Chi è responsabile se l’Ai sbaglia?
Un interessante articolo (“Who is Responsible When AI Fails? Mapping Causes, Entities, and Consequences of AI Privacy and Ethical Incidents“) ha analizzato 202 casi di reali “incidenti AI” per identificare cause, responsabilità e conseguenze.
Il lavoro è partito da questa semplice domanda:
“quali sono i tipi più comuni di incidenti di intelligenza artificiale e i fattori che li influenzano nelle fasi del ciclo di vita del sistema di intelligenza artificiale?”
Lo studio evidenzia che la maggior parte degli incidenti si verifica nelle fasi di applicazione e utilizzo dell’AI e spesso deriva da carenze organizzative come la mancanza di trasparenza o il mancato rispetto delle normative.
La ricerca sottolinea la necessità di migliorare la governance e i meccanismi di segnalazione degli incidenti, specialmente da parte degli sviluppatori e delle organizzazioni che adottano l’AI, per affrontare in modo efficace i rischi, com la diffusione di disinformazione e il rafforzamento dei pregiudizi.
Secondo l’analisi (si tratta di incidenti reali avvenuti tra il 2023 e il 2024), le cause e le responsabilità non sono limitate a errori tecnici, ma sono quindi radicate in decisioni organizzative e comportamenti umani.
Le Cause
L’analisi classifica le cause in quattro categorie principali, evidenziando che la maggior parte dei problemi deriva da decisioni umane e aziendali piuttosto che da guasti autonomi della tecnologia.
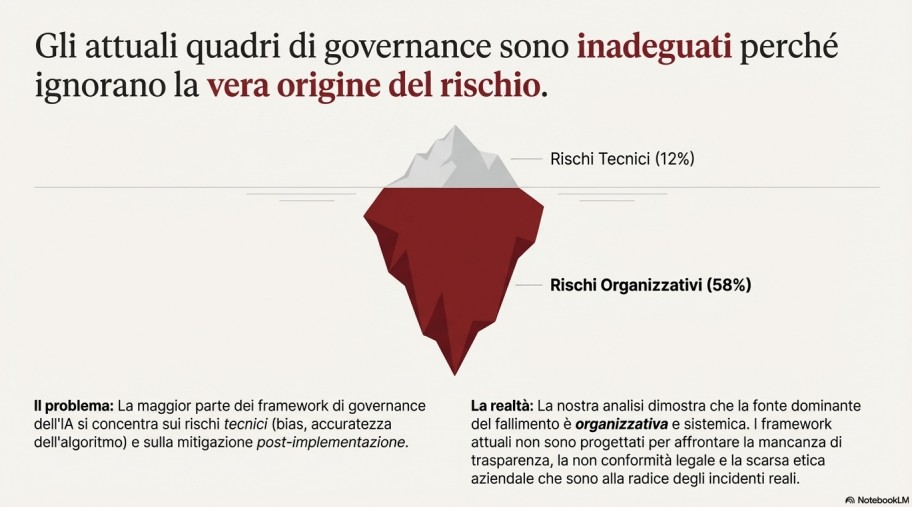
- Cause organizzative (58%): è la categoria predominante. Gli incidenti nascono dalle politiche, dalle pratiche o dai processi decisionali delle organizzazioni che sviluppano o adottano l’AI.
-
-
- Mancanza di consenso informato e trasparenza: la causa più frequente. Si verifica quando gli utenti non vengono informati su come i loro dati vengono raccolti o utilizzati (es. addestramento di modelli senza notifica).
- Non conformità legale: incidenti derivanti dalla violazione di standard legali come il GDPR.
- Scarsa etica aziendale: si tratta dell’adozione e dell’utilizzo di sistemi non testati o non sicuri, per profitto, o della vendita non autorizzata dei dati degli utenti.
- Mancanza di policy sulle piattaforme: assenza di meccanismi di moderazione efficaci per prevenire la diffusione di contenuti dannosi (come ad es. il deep fake).
-
- Cause umane (34%): incidenti che derivano da azioni o malintesi delle persone che interagiscono con i sistemi AI.
-
-
- Abuso degli strumenti: l’uso intenzionale per scopi non etici o illegali da parte di attori malintenzionati, come la creazione di deepfake non consensuali o campagne di disinformazione.
- Eccesso o mancanza di fiducia: l’accettazione cieca dei risultati, senza supervisione (come arresti basati su riconoscimenti facciali errati) o, al contrario, lo scetticismo che porta al rifiuto di tecnologie potenzialmente utili.
-
- Cause tecniche e di sviluppo
-
-
- Cause tecniche sono ad esempio errori negli algoritmi, allucinazioni, bias, malfunzionamenti o inefficienze che producono output inaffidabili.
- Decisioni di programmazione dei sistemi con funzioni problematiche (per esempio software di sorveglianza dei dipendenti o app che spogliano le persone).
-
- Mancanze regolamentari: lacune legislative che permettono utilizzi senza supervisione o usi per influenzare l’opinione pubblica.
I responsabili
La responsabilità non ricade su un unico attore, ma è distribuita tra chi crea, chi usa e chi adotta la tecnologia.
Si tratta delle aziende che sviluppano e degli sviluppatori stessi, responsabili principalmente per l’uso secondario dei dati (per addestramento o funzioni) senza consenso, per le politiche vaghe o per la deliberata inosservanza delle regole, ma non solo. La responsabilità è ascrivibile anche alle aziende che integrano i modelli nelle loro attività (deployer, secondo l’AI Act) con scarsa etica aziendale.
Non mancano gli utenti finali.
La stragrande maggioranza di questa categoria è rappresentata da umani malintenzionati, i principali responsabili di incidenti legati a immagini non consensuali, impersonificazioni, truffe e bypass delle misure di sicurezza dell’IA.
Infine le grandi piattaforme social o i forum che aggregano dati, responsabili in casi come la vendita non autorizzata di dati utente per l’addestramento dell’IA.
In sintesi
Oltre la metà degli incidenti (58%) deriva da fallimenti organizzativi, come la mancanza di trasparenza e la violazione delle normative, piuttosto che da errori del software o da attacchi esterni.
Le aziende sviluppatrici e i deployer raramente divulgano autonomamente questi incidenti (meno del 5% dei casi), che vengono invece portati alla luce principalmente da vittime, media o autorità esterne.
Si può pensare agli incidenti che coinvolgono l’AI come agli incidenti automobilistici: mentre alcuni sono causati da un guasto meccanico imprevisto o da un guidatore che viola intenzionalmente il codice della strada, la maggior parte dei problemi attuali, secondo la ricerca, deriva da produttori che vendono auto poco sicure, ignorando le normative pur di metterle sul mercato.
Per chi fosse interessato, una “interpretazione” dell’articolo da parte di Notebook LM, disponibile qui: AI_Failure_The_Or
👾 👾 👾
Alla prossima settimana!
Immagini: @pixabay