

Frid_AI_news #084 (31/07/2026)
Alla scoperta delle norme dedicate all’intelligenza artificiale
Il 10 giugno 2026 la Commissione europea ha pubblicato la versione finale del Code of Practice on Transparency of AI-Generated Content, il codice di condotta volontario elaborato da esperti indipendenti attraverso un processo multi stakeholder.
Il documento è organizzato in due sezioni distinte con destinatari diversi:
- la Sezione 1 si rivolge ai provider di sistemi di intelligenza artificiale generativa e attua l’articolo 50, commi 2 e 5, dell’AI Act (pag. 5-24),
- la Sezione 2 si rivolge ai deployer, cioè alle organizzazioni che utilizzano operativamente questi sistemi, e attua l’articolo 50, commi 4 e 5 (pag. 26-36).
Il testo ha un obiettivo duplice: da un lato fungere da guida per dimostrare conformità agli obblighi di legge, dall’altro permettere alle autorità di vigilanza di valutare quella conformità in modo uniforme in tutta l’Unione, con la precisazione esplicita che l’adesione al Codice non costituisce prova conclusiva di conformità (pag. 5 e pag. 26).
Il Codice copre solo i commi 2, 4 e 5 dell’articolo 50. I commi 1 e 3, che riguardano rispettivamente l’obbligo di informare le persone quando interagiscono con un sistema di IA (ad esempio un chatbot) e l’obbligo di informare le persone esposte a sistemi di riconoscimento delle emozioni o categorizzazione biometrica, restano fuori dal perimetro di questo testo.
Obblighi per i provider
Il tema centrale della Sezione 1, quella per i provider, resta l’obbligo di marcatura a doppio livello degli output sintetici (metadati con firma digitale più watermark impercettibile), con due eccezioni: prodotti fisici a ambiente chiuso e testo libero, per cui basta il watermark, esentato peraltro sotto la soglia dei 200 token (misura 1.1, pag. 8-10).
Altro obbligo è quello della rilevabilità delle marcature: i provider devono mettere a disposizione una soluzione di rilevamento, gratuita per l’utenza generale, con una deroga per chi ha meno di un milione di utenti mensili e sostiene costi operativi rilevanti (può applicare una tariffa proporzionata solo oltre una soglia ragionevole di richieste), mentre l’accesso gratuito e senza alcun limite di volume resta sempre garantito ad autorità di vigilanza, forze dell’ordine, media, fact-checker, ricercatori indipendenti e organizzazioni della società civile (misura 2.1, pag. 12-14).
Per il testo libero, dato il livello di affidabilità potenzialmente più basso del watermark, l’accesso al meccanismo di rilevamento può essere ristretto a utenti esperti verificati (sotto misura 2.1.2, pag. 13) e lo stesso vale per il meccanismo di rilevamento forense, tecnica opzionale che il Codice considera esplicitamente non ancora matura al momento della pubblicazione (misura 2.2, pag. 15).
Da segnalare che il Codice richiede una politica di conservazione zero per i contenuti sottoposti a rilevamento, da cancellare immediatamente dopo l’elaborazione salvo minimi log di sicurezza (sotto misura 2.1.3, pag. 14).
Il terzo impegno della Sezione 1 fissa i requisiti qualitativi delle soluzioni di marcatura e rilevamento: efficacia, affidabilità, robustezza (comprensiva sia della resistenza a operazioni comuni come compressione, ritaglio, stampa e nuova scansione, sia della resistenza a tentativi deliberati di rimozione o alterazione) e interoperabilità.
Coloro che firmeranno il Codice si impegnano a implementare una soluzione di interoperabilità tra i propri meccanismi di rilevamento entro il 2 febbraio 2027, scegliendo tra quattro opzioni tecniche equivalenti (un metodo di accesso standard industriale, un segnale leggibile pubblicamente nel contenuto, una soluzione condivisa tra consorzi di firmatari, o una soluzione comparabile) (misura 3.4, pag. 18-19). Misura, come detto valida solo per i firmatari, non una scadenza di legge autonoma dell’AI Act, il quale si limita a richiedere interoperabilità “nella misura tecnicamente fattibile”.
Il quarto impegno riguarda testing, verifica e conformità: i provider devono documentare un processo di compliance, testare le proprie soluzioni prima dell’immissione sul mercato e periodicamente in seguito, formare il personale coinvolto e cooperare con le autorità di vigilanza ai sensi dell’articolo 74 dell’AI Act, con la garanzia che segreti commerciali e informazioni riservate restano protetti secondo l’articolo 78 (misura 4.4, pag. 21-22).
Obblighi per i deployer
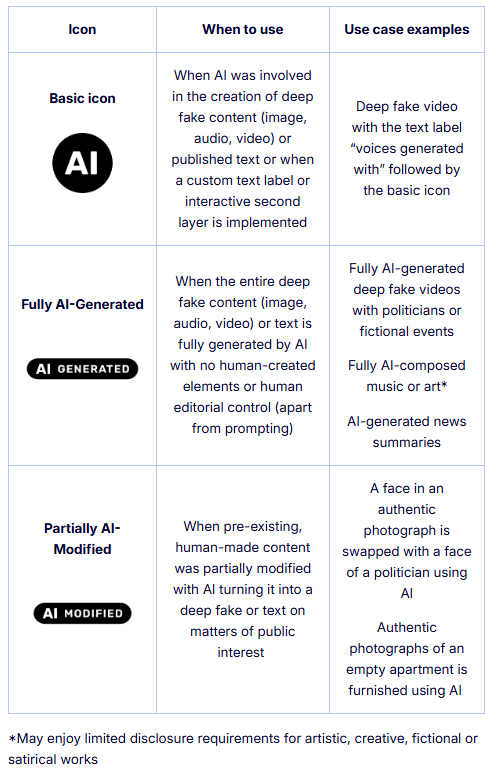
Sul versante della Sezione 2, quella per i deployer, il tema centrale è l’obbligo di etichettare in modo chiaro e distinguibile i deep fake (immagini, audio o video che sembrerebbero autentici a una persona) e i testi generati o manipolati dall’IA pubblicati su temi di interesse pubblico senza revisione editoriale.
Il Codice mette a disposizione un’icona UE gratuita in due varianti testuali, “AI GENERATED” per contenuto interamente generato e “AI MODIFIED” per contenuto parzialmente manipolato (Annex 1, pag. 37-38): un dato interessante emerso dai test empirici richiamati nel documento è che le varianti con etichetta testuale esplicita hanno funzionato significativamente meglio, in termini di notorietà e chiarezza percepita dagli utenti, rispetto alla semplice sigla “AI”, quindi la scelta della variante testuale non è indifferente sul piano della compliance sostanziale.
Le specifiche di posizionamento (misura 1.2, pag. 31-33) impongono che l’icona sia incorporata nel contenuto, visibile fin dall’inizio del video e ripetuta a intervalli regolari e comunque dopo ogni interruzione pubblicitaria, per tenere conto di un uso frammentato o di uno screenshot; per il testo pubblicato, l’icona va posta in prossimità del titolo o nel colophon e anche i testi brevi, dove l’etichettatura diretta degraderebbe la leggibilità, restano soggetti all’obbligo tramite un avviso contestuale nell’interfaccia.
Due impegni della Sezione 2 completano il quadro e meritano attenzione operativa specifica. Il terzo impegno prevede un regime alleggerito per le opere evidentemente artistiche, creative, satiriche o fittizie: l’icona va comunque apposta, ma in modo che non ostacoli la fruizione dell’opera, ad esempio nei titoli di coda o nel materiale informativo di accompagnamento (pag. 35).
Il quarto impegno riguarda la responsabilità editoriale sul testo pubblicato: chi già rientra nella definizione di fornitore di servizi di media ai sensi del regolamento UE 2024/1083 e applica standard editoriali propri può avvalersi dell’esenzione già prevista dall’articolo 50, comma 4, secondo periodo, dell’AI Act; tutti gli altri devono istituire una politica interna di revisione editoriale che identifichi nominativamente la persona fisica o giuridica responsabile, con contatti pubblicati se non già disponibili (pag. 35-36), un adempimento concreto e spesso trascurato da chi pubblica contenuti generati dall’IA su blog aziendali o portali informativi.
Implicazioni operative
Per chi lavora quotidianamente con questi strumenti, la prima cosa da chiarire internamente è quale ruolo l’organizzazione riveste caso per caso: provider quando sviluppa un proprio sistema generativo, deployer quando lo utilizza per produrre deep fake o testo destinato al pubblico su temi di interesse. La stessa organizzazione può trovarsi in entrambi i ruoli contemporaneamente, con obblighi diversi e cumulativi.
Se l’organizzazione è provider, il team tecnico deve verificare concretamente se il sistema in uso implementa davvero i due livelli di marcatura richiesti e non solo uno, e se esiste una funzione di rilevamento accessibile, quantomeno gratuitamente per autorità e ricercatori.
Se l’organizzazione è deployer, chi si occupa di comunicazione, marketing o pubblicazione di contenuti deve integrare la scelta e il posizionamento dell’icona nel flusso di lavoro editoriale, non come aggiunta finale ma come passaggio strutturale, dato che il Codice richiede la presenza dell’etichetta fin dal primo contatto e la sua persistenza nel tempo per contenuti lunghi o dal vivo.
Problematiche applicative
Ricordato che il Digital Omnibus sull’AI ha prorogato l’entrata in vigore degli obblighi di cui parliamo al 2 dicembre 2026, gli esperti rilevano come i meccanismi di rilevamento forense non siano ancora maturi e che il watermarking su testo libero oltre i 200 token può avere affidabilità ridotta; ne consegue che un’organizzazione che si limiti a implementare quanto richiesto come minimo indispensabile potrebbe comunque trovarsi, in un contesto di controllo reale, con marcature che non superano la verifica per ragioni intrinseche allo stato dell’arte, non per un proprio inadempimento. È una circostanza di cui tenere conto.
Un secondo punto riguarda la scadenza del 2 febbraio 2027 per l’interoperabilità dei meccanismi di rilevamento: essendo un impegno del Codice e non un obbligo di legge autonomo, il mancato rispetto di quella data specifica non equivale automaticamente a una violazione dell’articolo 50 dell’AI Act, ma indebolisce la posizione di chi voglia invocare l’adesione al Codice come elemento di conformità.
Infine, come già rilevato, il perimetro degli obblighi dell’articolo 50, commi 1 e 3, dell’AI Act (informazione su interazione con IA e su sistemi di riconoscimento emotivo o categorizzazione biometrica) non è coperto da questo Codice.
Rischi e conseguenze del mancato assolvimento
Il quadro sanzionatorio discende dall’AI Act indipendentemente dal Codice e si combina, per il contesto italiano, con la legge 132/2025, inclusi i suoi profili penali relativi ai contenuti sintetici non dichiarati come tali.
Al di là della sanzione formale, il rischio concreto per un’organizzazione che non implementi correttamente l’etichettatura dei deep fake o del testo generato è la contestazione in sede di vigilanza, aggravata dall’impossibilità di invocare l’adesione al Codice come elemento a proprio favore se quell’adesione non è stata perfezionata o se le misure implementate restano al di sotto degli standard descritti.
Piano d’azione pratico
Un percorso operativo aggiornato, da avviare subito, potrebbe essere il seguente.
Primo passo: censire i sistemi di intelligenza artificiale generativa in uso, distinguendo per ciascuno il ruolo dell’organizzazione, provider oppure deployer, e se deployer, se il contenuto prodotto rientra nella definizione di deep fake o di testo pubblicato su temi di interesse pubblico senza controllo editoriale.
Secondo passo, per i sistemi in cui l’organizzazione è provider: verificare l’implementazione del doppio livello di marcatura, predisporre o verificare l’esistenza di una soluzione di rilevamento gratuita con accesso senza restrizioni per autorità e ricercatori e programmare la verifica del requisito di interoperabilità in vista della scadenza del 2 febbraio 2027.
Terzo passo, per i contenuti in cui l’organizzazione è deployer: adottare l’icona UE nella variante con etichetta testuale esplicita, non la sola sigla “AI”, verificarne il posizionamento secondo le specifiche (inizio contenuto, intervalli regolari, dopo interruzioni, prossimità al titolo per il testo) e distinguere il regime alleggerito per le opere evidentemente artistiche o satiriche.
Quarto passo: per i testi generati dall’IA pubblicati su temi di interesse pubblico senza revisione editoriale, nominare formalmente la persona fisica o giuridica responsabile della redazione e pubblicarne i contatti, salvo l’organizzazione rientri nell’esenzione riservata ai fornitori di servizi di media già soggetti a standard editoriali propri.
Quinto passo: rivedere i termini d’uso per includere il divieto di manomissione delle marcature, se non già presente.
Sesto passo: documentare un processo interno di compliance secondo la misura 4.1, proporzionato alla dimensione dell’organizzazione, pronto per essere esibito alle autorità di vigilanza su richiesta motivata, con la consapevolezza che segreti commerciali e informazioni riservate restano protetti ai sensi dell’articolo 78 dell’AI Act.
👾 👾 👾
Alla prossima!