
Alla scoperta delle norme dedicate all’intelligenza artificiale
Privacy e LLM
L’EDPB indica come comprendere i rischi e impostare strategie di mitigazione
Nel panorama in rapida evoluzione dell’intelligenza artificiale, i Large Language Models (LLM) come GPT-4, Claude, Gemini e altri, stanno ridefinendo le possibilità di interazione uomo-macchina.
Come abbiamo più volte evidenziato, tuttavia, queste tecnologie portano con sé significative sfide in termini di privacy e di protezione dei dati personali.
Un recente rapporto pubblicato dall’EDPB (European Data Protection Board) analizza in profondità i rischi per la privacy associati ai sistemi LLM e le relative strategie di mitigazione.
Una nuova era dell’IA: dagli LLM agli agenti autonomi
I Large Language Models sono modelli di intelligenza artificiale addestrati su vasti set di dati testuali e, in alcuni casi, multimodali (testo, immagini, audio).
L’architettura basata sui Transformer, con i sofisticati meccanismi di attenzione, consente loro di comprendere e generare linguaggio naturale in modo sempre più indistinguibile da quello umano.
Ma l’evoluzione non si ferma qui: entro il 2027 si prevede che il 50% delle aziende che utilizzano tecnologie di IA generativa avranno implementato progetti pilota di IA agentica, ossia sistemi autonomi in grado di pianificare, ragionare e prendere decisioni con minima supervisione umana (v. pagina 12 del rapporto).
Tre modelli di implementazione, tre diversi profili di rischio
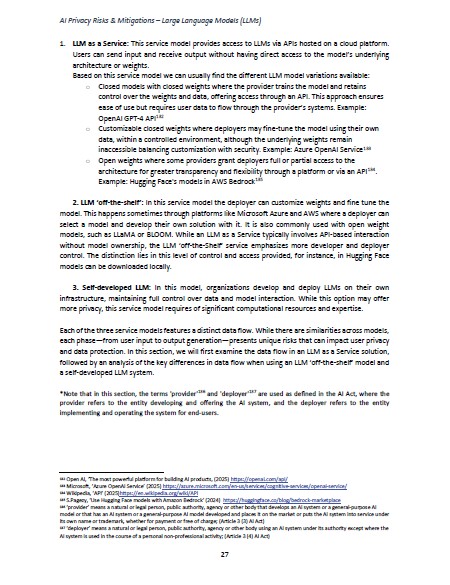
Quando si tratta di integrare gli LLM nei flussi di lavoro aziendali, esistono tre modelli principali di servizio, ciascuno con il proprio profilo di rischio:
- LLM as a Service: con accesso tramite API cloud (es. OpenAI, Anthropic, Cohere)
- LLM “off-the-shelf”: modelli pre addestrati personalizzabili (es. Hugging Face, Llama)
- LLM auto-sviluppati: sistemi progettati e implementati internamente.
Comprendere le differenze tra questi modelli è fondamentale per una corretta allocazione delle responsabilità e per l’implementazione di strategie di mitigazione efficaci.
Il documento può essere utile sia agli sviluppatori, sia agli utilizzatori sia ai decisori: si tratta, come sempre, di comprendere a fondo i possibili rischi, le opportunità, analizzarle, valutarle e adottare strategie di mitigazione.
Gli sviluppatori possono farlo integrando la gestione del rischio privacy nel ciclo di vita del modello; gli utilizzatori analizzando i possibili rischi derivanti dal deployment, così adottando adeguate politiche di utilizzo e gestione, mentre i decision makers possono avere approfondita contezza delle questioni di compliance e adottare decisioni adeguatamente risk based.
Il Capitolo 4 su data protection e risk assessment per la privacy
Il capitolo 4 è intitolato “Data Protection and Privacy Risk Assessment: Risk Identification” e si concentra sulla prima fase fondamentale del processo di valutazione del rischio: l’identificazione dei potenziali rischi per la privacy e la protezione dei dati nei sistemi basati su LLM.
Il capitolo è strutturato in due sezioni principali:
- Criteri da considerare nell’identificazione dei rischi
- Esempi di rischi per la privacy nei sistemi LLM
Il capitolo segue una progressione logica che guida il lettore dalla comprensione teorica dei fattori di rischio verso l’applicazione pratica.
L’identificazione del rischio è il primo passo fondamentale nella gestione del rischio.
I fattori di rischio sono presentati come condizioni che indicano una maggiore probabilità di esiti indesiderati. Questi fattori derivano da elementi normativi come il GDPR e le tante norme regolatorie; ad esempio:
- decisioni automatizzate che influenzano o possono avere conseguenze su diritti fondamentali
- trattamento di dati “sensibili” come categorie speciali di dati, dati finanziari, dati comportamentali
- trattamenti su larga scala di elevati volumi di dati personali
- trattamento di dati di soggetti vulnerabili, come bambini, anziani, persone con disabilità
- bassa qualità dei dati di input o di addestramento
- misure di sicurezza insufficienti.
Il capitolo continua sottolineando l’importanza, nella valutazione dei rischi, di considerare lo scopo previsto dal trattamento (v. Considerando 90 del Gdpr) unitamente al concreto contesto operativo, perché spesso i rischi emergono quando i sistemi vengono utilizzati in modi non previsti o in contesti che introducono vulnerabilità impreviste.
Introduce, poi, il threat modeling come approccio strutturato per identificare sistematicamente i rischi, insieme all’importanza dell’evidenza empirica.
Suggerisce, quindi di porsi quattro domande fondamentali:
- Su cosa stiamo lavorando?
- Cosa potrebbe andare storto?
- Cosa faremo al riguardo?
- Abbiamo fatto un buon lavoro?
Il monitoraggio e la raccolta di prove sono presentati come elementi essenziali di un’identificazione del rischio basata sull’evidenza, integrando fonti di dati da registri e modelli di utilizzo, risultati di valutazione, feedback degli utenti.
Mediante un approccio strutturato all’identificazione del rischio, evidenziando la condivisione di responsabilità tra i vari attori (provider, deployer, team di procurement), con responsabilità diverse ma complementari, sottolineando l’importanza di valutare attentamente il contesto di utilizzo dei modelli e di mantenere evidenze empiriche delle analisi e delle valutazioni, il report contribuisce a far comprendere l’importanza di identificare i rischi per poi quantificarli e valutarli.
Il Capitolo 9: gli esempi pratici
Il report contiene tre esempi pratici di risk assessment, strutturati e completi di valutazione del rischio (architettura del modello, identificazione, analisi e valutazione del rischio), applicazione (trattamento) di contromisure.
Vediamoli qui, brevemente riassunti.
1. Assistente virtuale per servizio clienti
Un’azienda di attrezzature da cucina implementa un chatbot per rispondere alle domande frequenti. L’assistente accede al CRM per personalizzare le risposte.
Rischi principali:
- esposizione di dati sensibili negli input utente
- vulnerabilità nelle interfacce API
- possibili output inaccurati che potrebbero danneggiare l’immagine aziendale
Mitigazioni chiave:
- implementazione di crittografia end-to-end
- meccanismi di convalida degli input
- filtri per il rilevamento di contenuti sensibili negli output
2. Sistema di monitoraggio del progresso degli studenti
Una scuola adotta un sistema LLM per monitorare e valutare le performance accademiche degli studenti, fornendo raccomandazioni personalizzate.
Rischi principali:
- trattamento di dati personali di minori
- possibili decisioni automatizzate con impatti significativi
- bias che potrebbero penalizzare determinati gruppi di studenti
Mitigazioni chiave:
- ottenere il consenso esplicito dei genitori
- assicurare l’intervento umano per decisioni critiche
- audit regolari per rilevare e correggere possibili bias
3. Assistente IA per gestione viaggi
Un agente IA aiuta gli utenti a pianificare viaggi, prenotare voli e hotel, e gestire la propria agenda quotidiana.
Rischi principali:
- condivisione di dati con piattaforme di terze parti
- inferenza di categorie speciali di dati dalle preferenze di viaggio
- rischio di profilazione e trattamento non equo (es. discriminazione di prezzo)
Mitigazioni chiave:
- limitare la raccolta di dati allo stretto necessario
- implementare meccanismi di conferma utente per decisioni critiche
- verificare la conformità dei fornitori terzi con le normative sulla protezione dei dati
Un framework strutturato per la gestione del rischio
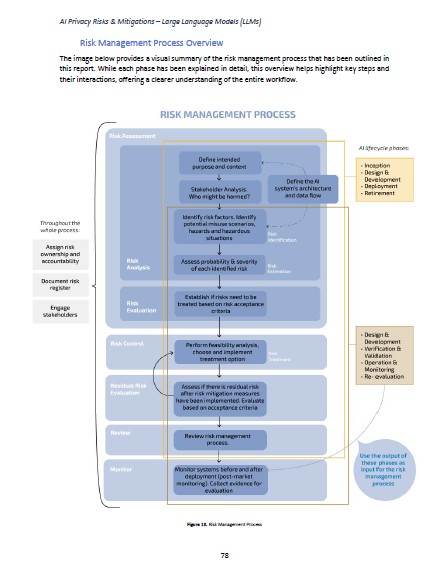
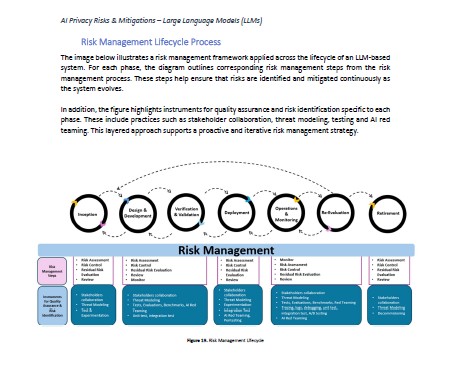
Per gestire efficacemente i rischi associati ai sistemi LLM, è quindi essenziale adottare un approccio strutturato che copra l’intero ciclo di vita dell’IA.
Identificare il rischio, stimarlo e valutarlo, controllarlo con misure di mitigazione ove presente; valutare anche l’eventuale rischio residuo e, successivamente, monitorare continuamente l’applicazione e l’utilizzo del modello.
Possiamo quindi indicare alcuni passaggi pratici fondamentali:
- Mappare il flusso dei dati: comprendere dove e come i dati personali vengono elaborati nelle diverse fasi del sistema LLM
- Adottare un approccio multi-stakeholder, coinvolgendo esperti di privacy, di sicurezza, di etica e i rappresentanti degli utenti finali nelle valutazioni del rischio
- Implementare la soluzione con processi by Design, integrando considerazioni sulla privacy fin dalle prime fasi di progettazione, non come una “pezza” successiva
- Verificare la conformità dei fornitori – terze parti, assicurandosi che rispettino gli standard di protezione dei dati richiesti
- Documentare le valutazioni: mantenere un registro dei rischi aggiornato e documentare le decisioni è sicuramente elemento di accountability
- Non dimenticare di prevedere meccanismi di supervisione umana, soprattutto per decisioni che potrebbero avere un impatto significativo sugli individui
- Pianificare il monitoraggio continuo con metriche di prestazione, test e richieste di feedback agli utenti.
Il futuro della privacy nell’era dell’IA generativa
Mentre ci avviciniamo a un’era in cui gli agenti IA autonomi diventeranno sempre più presenti nelle nostre vite quotidiane, la gestione della privacy e la protezione dei dati diventeranno (modifiche permettendo…) ancora più cruciali.
L’AI Act europeo rappresenta un primo passo significativo verso la regolamentazione di queste tecnologie, ma sarà responsabilità di tutti noi – sviluppatori, implementatori e utenti – garantire che l’innovazione proceda di pari passo con il rispetto dei diritti fondamentali.
La sfida non è semplicemente tecnica, ma anche etica e sociale.
👾 👾 👾
Ci vediamo la prossima settimana.
Questa newsletter si propone di esaminare le principali disposizioni in arrivo con un linguaggio semplice e chiaro, accompagnato il più possibile da esempi concreti.
Se sei interessato, iscriviti. 👾